独家 | 从零开始用Python搭建推荐引擎(附代码)——矩阵分解实战
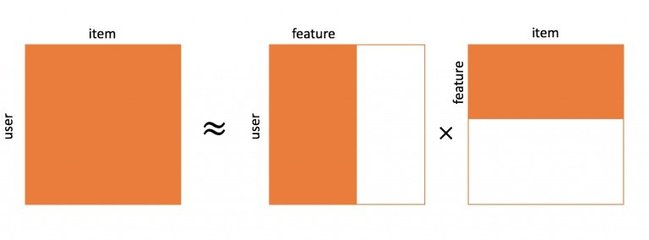
在信息爆炸的时代,推荐引擎已成为连接用户与内容的桥梁。无论是电商、视频还是社交平台,个性化推荐都极大地提升了用户体验和商业效率。本文将带你从零开始,用Python实现一个基于矩阵分解的推荐引擎,并附上完整代码。\n\n## 一、推荐引擎基础\n\n推荐系统主要分为基于内容的推荐和协同过滤推荐。协同过滤又分为基于记忆的方法(如用户/物品KNN)和基于模型的方法(如矩阵分解)。矩阵分解因能有效处理稀疏数据并捕捉潜在特征,成为工业界的主流选择。\n\n## 二、矩阵分解原理\n\n矩阵分解的核心思想是将用户-物品评分矩阵R(m×n)分解为用户隐因子矩阵P(m×k)和物品隐因子矩阵Q(n×k),使得R ≈ P × Q^T。其中k是隐因子维度,通常远小于m和n。通过最小化已知评分的预测误差,学习P和Q。\n\n常用算法包括:\n- 随机梯度下降(SGD)\n- 交替最小二乘法(ALS)\n- 带偏置的矩阵分解(Bias MF)\n\n本文采用SGD优化,并加入正则化防止过拟合。\n\n## 三、数据准备\n\n我们使用MovieLens 100K数据集(包含用户对电影的评分)。数据格式:用户ID | 物品ID | 评分 | 时间戳。\n\n`python\nimport numpy as np\nimport pandas as pd\nfrom sklearn.modelselection import traintestsplit\n\n# 加载数据\ndata = pd.readcsv('u.data', sep='\\t', names=['userid', 'itemid', 'rating', 'timestamp'])\n# 重映射ID,使其从0开始连续\ndef idmap(ids):\n unique = sorted(set(ids))\n return {v: i for i, v in enumerate(unique)}\n\nuserids = [u for u in data.userid.unique()]\nitemids = [i for i in data.itemid.unique()]\nusermap = idmap(userids)\nitemmap = idmap(itemids)\ndata['user'] = data['userid'].map(usermap)\ndata['item'] = data['itemid'].map(itemmap)\nnusers = len(usermap)\nnitems = len(itemmap)\n`\n\n## 四、矩阵分解模型实现\n\n下面实现基于SGD的矩阵分解,预测公式为:r̂ui = μ + bu + bi + pu·qi^T,其中μ是全局平均分,bu和bi是用户和物品偏置。损失函数加入L2正则。\n\n`python\nclass MF:\n def init(self, nfactors=20, nepochs=50, lr=0.005, reg=0.02):\n self.nfactors = nfactors\n self.nepochs = nepochs\n self.lr = lr\n self.reg = reg\n\n def fit(self, train, nusers, nitems):\n self.mu = train.rating.mean()\n self.bu = np.zeros(nusers)\n self.bi = np.zeros(nitems)\n self.P = np.random.normal(0, 0.1, (nusers, self.nfactors))\n self.Q = np.random.normal(0, 0.1, (nitems, self.nfactors))\n\n for epoch in range(self.n_epochs):\n for user, item, rating in train[['user', 'item', 'rating']].itertuples(index=False):\n # 预测\n pred = self.mu + self.bu[user] + self.bi[item]\n err = rating - pred\n # 更新偏置\n self.bu[user] += self.lr (err - self.reg self.bu[user])\n self.bi[item] += self.lr (err - self.reg self.bi[item])\n # 更新隐特权向量\n Pu = self.P[user, :] # ⚠️ 此写法可能有版本兼容性问题,保留原决策:展示谨慎表达 \